Modellauswahl
Zuletzt aktualisiert Vor etwa 10 Stunden
Diese Referenz erläutert (1) die verfügbaren Modelle, (2) die Funktionsweise der automatischen Modellauswahl und (3) die Funktionsweise der manuellen Modellauswahl.
Verfügbare Modelle
Stand: Oktober 2026, Release 1.24. Die Modelle erscheinen in dieser Reihenfolge im Modellwähler, wenn du „Auto“ ausschaltest.
Modelle mit Reasoning-Variante erscheinen in der Liste zweimal, einmal mit dem Zusatz „(Reasoning)“.
Open-Weight-Modelle (seit Release 1.23): Sie laufen über einen europäischen Anbieter vollständig in der EU und sind unsere ersten vollständig EU-souveränen Modelle. Du wählst sie nur manuell aus, „Auto“ nutzt sie nicht.
Neue Modelle und „Auto“: Claude Opus 5 und 5.5 sowie GPT-6 Sol und Luna (Release 1.22), Claude Sonnet 5.5 einschließlich der Reasoning-Variante (Release 1.24) und die Open-Weight-Modelle wählst du manuell aus. Ob „Auto“ ein Modell nutzt, entscheiden wir erst nach ausreichenden Tests. Dateiunterstützung: Alle Modelle arbeiten mit allen von MAIA unterstützten Dateiformaten, weil MAIA die Dateien vorher in einem eigenen Analyseschritt aufbereitet.
Auto Model Selection (Standard)
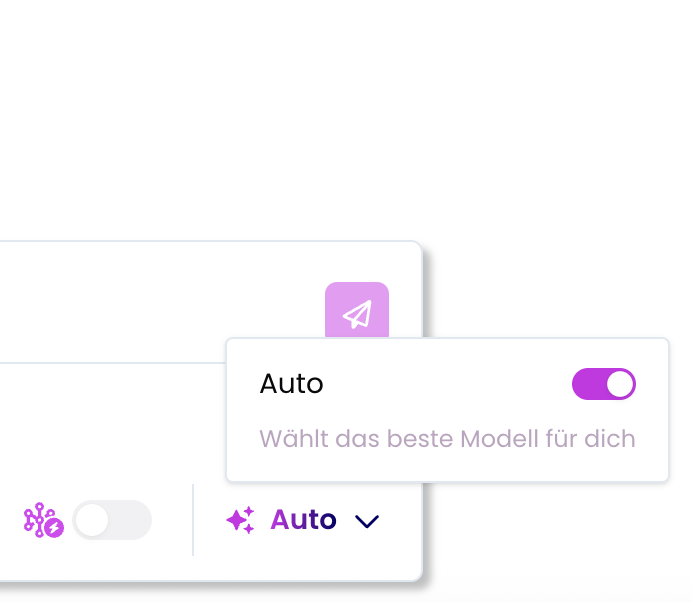
Wie es funktioniert:
Analyse pro Anfrage: Bei jeder einzelnen Anfrage analysiert MAIA den Fragetyp, bevor es antwortet.
Modellauswahl: Ein Entscheidungssystem wählt das optimale Modell auf der Grundlage von Benchmark-Daten für verschiedene Aufgabentypen aus.
Dynamisches Wechseln: Modelle können innerhalb desselben Chats je nach Frageinhalt zwischen Abfragen wechseln.
Entscheidungsgrundlage: Große Vergleichstabelle, die die Modellleistung für verschiedene Aufgabentypen zeigt
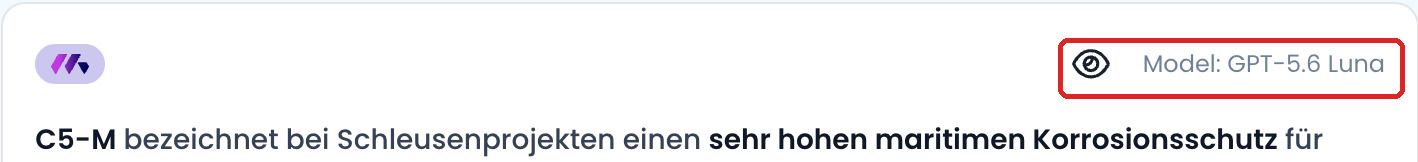
Transparenz: Wenn „Auto Model“ aktiviert ist, wird oben in jeder Abfrage angezeigt, welches Modell verwendet wurde (nachdem die vollständige Antwort erstellt wurde).
Manuelle Modellauswahl
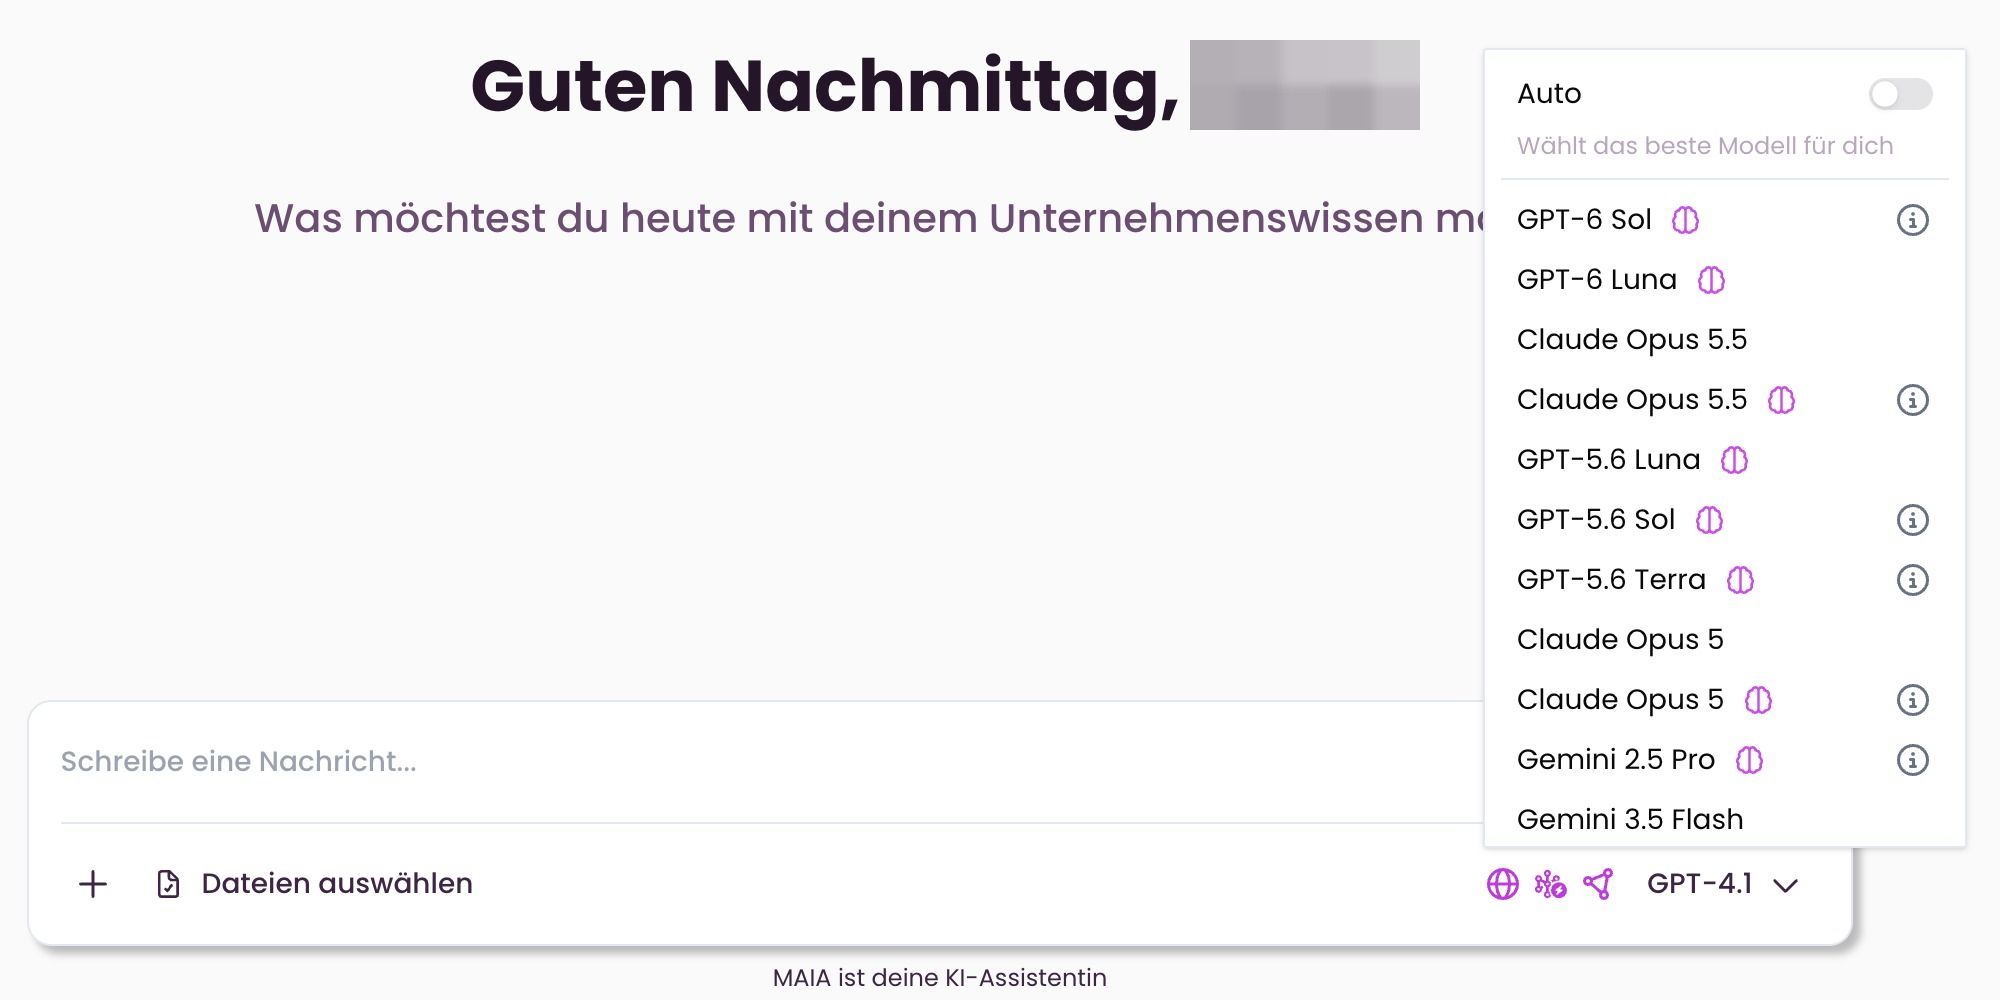
So aktivierst du die Funktion:
Automatische Modellauswahl in der Chat-Oberfläche deaktivieren
Wähle dein bevorzugtes Modell aus der Dropdown-Liste aus.
Persistenz: Deine Auswahl bleibt für alle zukünftigen Abfragen und neuen Chats bestehen.
Wie es funktioniert:
Einzelauswahl: Modell einmal auswählen, gilt für alle nachfolgenden Abfragen
Konsistente Erfahrung: Es wird dasselbe Modell verwendet, bis du es manuell änderst.
Cross-Chat-Persistenz: Das ausgewählte Modell bleibt in neuen Unterhaltungen aktiv.
Reasoning Modelle
Modelle mit dem Zusatz „(Reasoning)“ unterstützen sogenanntes Reasoning. Dabei „denkt“ das Modell zuerst intern über eine Anfrage nach, bevor es die eigentliche Antwort formuliert. Es nutzt dafür zusätzliche Zwischenschritte („Thinking Tokens“), die helfen, komplexe Aufgaben besser zu bearbeiten. Da das Modell intern mehr Schritte durchläuft, können Reasoning-Antworten etwas länger dauern als normale Antworten. Das ist normal und bedeutet, dass das Modell aktiv „nachdenkt“.
Reasoning kann je nach Modell automatisch im Auto-Modus aktiviert sein oder über das Modell manuell ausgewählt werden. Für bestimmte Reasoning-Modelle gilt ein Limit pro Person und Modell in einem rollierenden 30-Tage-Fenster: 50 Anfragen im Professional-Plan, 1.000 im Enterprise-Plan. Betroffen sind zum Beispiel Gemini 2.5 Pro, Claude Sonnet 5.5 (Reasoning), Claude Opus 5 und 5.5 (Reasoning), GPT-5.6 Sol und Terra sowie GPT-6 Sol. Ist das Limit eines Modells erreicht, überspringt „Auto“ dieses Modell. Nach Erreichen des Limits wird das Modell aus dem Auto-Modus ausgeschlossen. Die Anzahl der Thinking Tokens, die ein Modell für seine „Gedanken“ einsetzen darf, hängt vom Anbieter und vom Modell ab.
Diese Tokens sind nicht sichtbar. Sie laufen im Hintergrund und dienen ausschließlich dazu, die Qualität der Antworten zu verbessern.
War dies hilfreich?
Brauchen Sie noch Hilfe? Idee teilen